几十年来,语言学习一直建立在一个简单的假设之上:应该由某个人决定你需要学什么,把它排成正确的顺序,然后教给你。第一课在第二课之前,初级词汇在中级词汇之前,语法被切成一章一章,所谓进步就是在一门课程里往前走。这套模式在学习材料稀缺的年代是成立的。那个世界正在消失。
今天的学习者打开 YouTube,一个晚上听到的自然日语,可能比一本几百页的教材装得下的还多。播客、访谈、直播、剧集、新闻、社交媒体和线上社区,提供的真实语言在数量上基本是无限的。人工智能可以即刻解释一个看不懂的句子,词典一点就能认出一个词,语音识别能评估发音,翻译几乎无处不在。
问题不再是能不能接触到语言。新的问题是,拿这么多材料该怎么办——而这会改变语言学习最底层的结构。
旧范式从课程表开始
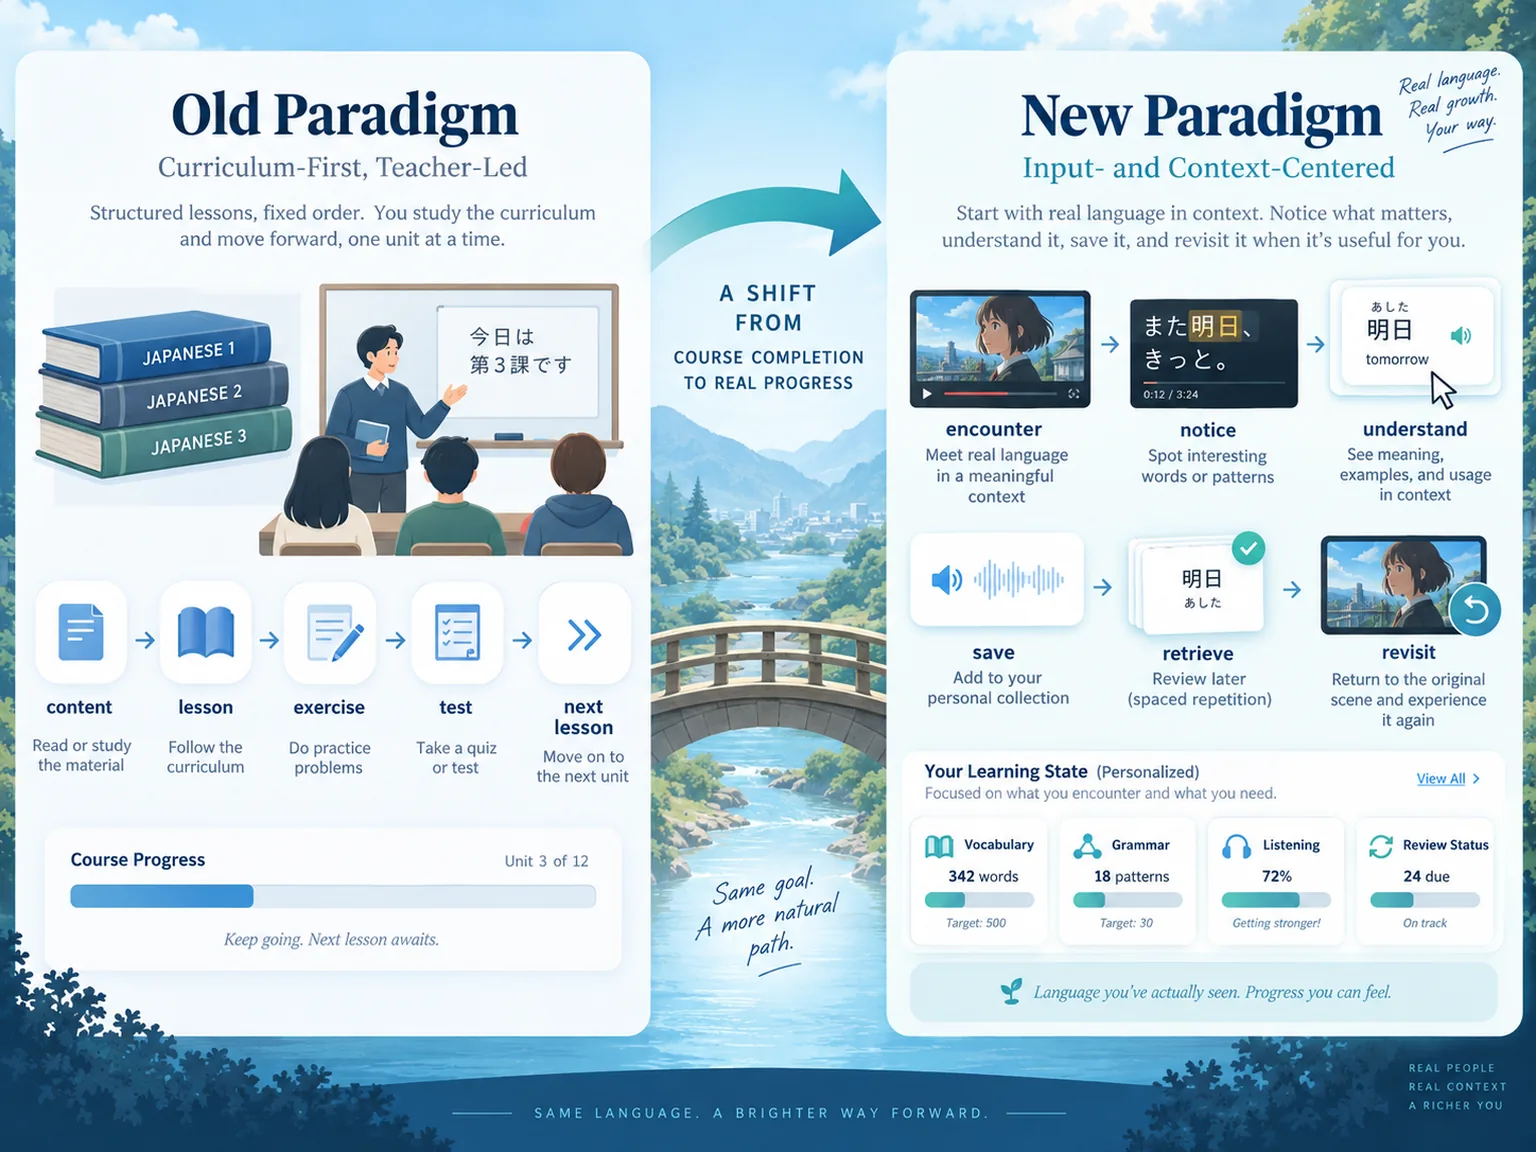
传统的语言教育是课程优先的。一门课程定义了一条顺序,学习者在事先选好的材料里往前走。
内容 → 课时 → 练习 → 测验 → 下一课
这有实实在在的好处。一份设计良好的课程能避免明显的知识空洞,把难的概念一点点引入,也能给初学者一个清楚的方向感。但它同时做了一个很强的假设:同一条顺序对大多数学习者都是合理的顺序。
真实的语言使用并不是这样组织的。因为在餐厅工作而学日语的人,遇到的语言和学工程的人完全不同。天天看游戏直播的人会反复撞见一些通用教材里可能永远不会出现的词。住在日本的人,可能在课程认为他"准备好了"很久之前,就突然需要看懂租房合同、医院对话或者职场用语。
对一个学习者来说最要紧的语言,越来越多地来自他自己的生活,而不是书的下一章。这指向一个不同的起点。与其问"这个学习者接下来该学哪一课",我们可以问:这个学习者实际上正在遇到什么、理解什么、忘掉什么、需要什么。这比把教材换成一个 App 要深得多。
从课时到遭遇
传统学习的基本单位是课时。正在浮现的这套模式,基本单位可能是"遭遇"——你和一句真实语言撞上的那一次。
设想你在一个日语视频里听到「このままだと間に合わないよ」。你没完全听懂,于是暂停,查了「間に合う」,明白了这句话,然后视频继续往下播。
在大多数数字学习系统里,重要的事情到这里就结束了:查词解决了当下的理解问题。但从学习的角度看,刚刚发生的事情要有价值得多。你遇到了一个词——由某个特定的人说出,在某个特定的句子里,带着某种特定的语调,处在一个有意义的情境中,而且是在你本人想要弄懂它的那一刻。
这不只是一个词条。这是一次学习事件——而未来的学习系统并不非得把它扔掉。它可以把它留下来。
从存词到留住情境
语言学习软件传统上一直在把知识切成越来越小的对象。一个句子变成一个词条,词条再变成「間に合う=来得及」。这让信息更好存、更好测,抽卡之所以有力,部分正来自这层抽象。
但抽象是有代价的。学习者当初遇到「間に合う」,是在一个场景里、一个声音里、一句话里、一个交流意图里。一旦被压缩成"词—释义"这一对,其中大部分信息就消失了。下一代系统完全有余力保留原始事件中更多的东西。
词 → 句子 → 声音 → 说话人 → 时间点 → 视频 → 情境
复习不再必须意味着盯着一张与来源脱节的卡片。它可以意味着回到这份知识当初真正重要的那个瞬间。这并不会让抽卡过时——提取练习和间隔重复依然是很强的机制。变的是"被提取的是什么"。与其反复提取一个孤立的译文,学习者可以连同它被使用的情境一起提取。这个区别要紧,因为知道一个词"是什么意思",和别人说出来时你能立刻听出来,并不是同一件事。
从内容分发到学习闭环
大多数教育软件到今天仍然像一个内容库:它给学习者东西去消费。更有用的模型是一个闭环。
遇见 → 注意 → 理解 → 保存 → 遗忘 → 取回 → 重访 → 再次遇见
最后一步才是关键。学习不应该总是在学习系统内部终结。如果一个短语是学习者在某个视频里发现的,系统最终可以把他送回那个视频——一周前完全听不懂的那句话,可能突然就变得显而易见。那一刻给学习者的东西,是任何词汇量分数都给不了的:他对真实语言的感知确实变了,而且有证据。
材料同时成了知识的来源,和进步变得可见的地方。视频不再是"拿来当补充输入的娱乐",而成为学习者记忆结构的一部分。
从固定顺序到学习者状态
课程式学习还有另一个局限。课程知道课程走到哪了,却不一定知道学习者走到哪了。
两个人可以上完一模一样的十节课,最后掌握的东西却差别巨大。一个人记住了大部分词汇,但听力吃力;另一个听得懂,却漏掉了语法;第三个知识都会,却因为在自然情境里遇到得不够多,处理得不够快。"第 10 课已完成"是对一个学习者极其糟糕的描述。
更有用的系统会维护一个不断变化的学习者状态模型。这个人遇到过什么?他能认出什么?他忘掉了什么?哪些语法反复出问题?哪些词在好几个视频里都出现过?哪些材料对他已经太简单了?哪些场景他几乎没接触过?
一旦这些问题变得可以回答,学习路径就不必再是同一条。课程表不再是一条修好的路,而变成一套导航系统。
AI 改变的是协调问题
这也是 AI 可能比"再提供一个聊天机器人"更要紧的地方。第一代 AI 语言学习产品大多集中在生成上:生成解释、生成练习、生成对话、生成课程。这些能力有用,但只靠生成并不能改变学习模型。机器生成的习题册,仍然是习题册。
更大的机会在于协调。一个足够聪明的系统,可以把原本散落在不同工具里的信息连起来:你昨天看了什么,你三周前保存了什么,你一直搞错的是什么,你已经掌握的是什么,你现在这个视频里出现了什么,以及接下来你最可能从遇到什么当中获益。
这样一来,AI 就不那么像一个说个不停的老师,而更像一层用来组织持续变化的学习环境的东西。
在我已经遇到过的这一切之上,我接下来该注意什么?
这个问题比"AI 能教我什么"难得多——也有意思得多。
未来不是"没有课程"
范式转移并不意味着之前的一切都是错的。初学者仍然需要结构。语法讲解仍然重要。刻意的词汇练习仍然重要。提取练习仍然重要。老师仍然重要。互动和产出仍然重要。而且,光有真实内容并不保证学得会:看几千小时听不懂的电视,不是一种学习策略。
变的是这些成分之间的关系。以教材为中心的模式说:先学这些,将来有一天你就能看懂真实世界。以输入为中心的模式越来越倾向于说:更早地进入真实世界,然后围绕那里发生的事情去搭建有结构的学习。正式教学从"接触真实语言的前提",变成"接触真实语言时的支撑"。
对"进步"的另一种定义
这也改变了进步的含义。传统系统很擅长度量学习者完成了什么:27 课、1200 个词、43 个语法点、课程完成度 86%。这些数字方便,是因为它们好数。但学习者开始学日语,很少是因为想把一门课程完成到 86%。
他们想要的更接近这些:一个曾经必须开字幕的视频,现在不用了;一句曾经快得不可思议的话,变得一听就懂;几个月前听过的一个说法,在对话里冒出来,当场就明白了;一个陌生的话题变得可以进入;那些原本把自己挡在外面的场合,现在可以参与了。
归根结底,进步是这个世界允许你理解和做到的事情发生了变化。学习系统应该在呈现这种变化上做得更好。
语言学习可能会变得不那么显眼
这里有个悖论。随着语言学习技术越来越成熟,"学一门语言"这个动作,可能会越来越难和"使用这门语言"分开。与其打开一门课程、学三十分钟、然后回到正常生活,学习可以分散在一次次普通的遭遇里。
看点什么。对某句话产生好奇。弄懂它。留下有用的部分。继续看。过些时候再遇到它。需要的时候复习一下。最后不再需要帮助。在这套模式里,"学日语"和"用日语"之间的边界越来越难找到——而这可能是所有转变里最重要的一个。
从一座课程的图书馆,到一份你语言生活的记忆
在 Mimora,我们正在探索的就是这个方向。与其把每个视频都当成用完即弃的输入,我们认为一个学习系统可以记住学习者和内容之间的关系:是哪个视频引入了这个词,是哪句话让它有了意义,保存了什么,什么需要复习,以及这份知识最初来自哪里。
但更大的那个想法并不属于某一个产品。语言学习技术正在慢慢地,从"主要用来分发教学内容的系统",走向"有能力组织学习者自己与一门语言的遭遇的系统"。这改变了语言教育最中心的那个问题。
这个学习者经历过什么,而这些经历接下来应该发生什么?
很长一段时间里,我们问的是"我们应该教给学习者什么"。下一代语言学习系统问的,可能越来越是上面这一句。这不只是一个新功能。这是另一种学习范式。